O futuro da IA on-device: WebNN, WebGPU e além
O futuro da IA on-device: WebNN, WebGPU e além
IA on-device no browser é, em essência, rodar inferência direto no dispositivo do usuário. Sem servidor no meio. Em junho de 2026, o ecossistema se organiza em três camadas: APIs built-in (Prompt API, Summarizer), frameworks JavaScript (Transformers.js, ONNX Runtime Web) e primitivas de hardware (WebNN, WebGPU).
TL;DR
- Ecossistema em 3 camadas: APIs built-in (Prompt API), frameworks JS (Transformers.js, ONNX), primitivas de hardware (WebNN, WebGPU)
- WebNN acessa NPUs dedicadas com 10-50x mais eficiência energética que GPU; WebGPU dá 4-5x speedup sobre WASM
- Estratégia 2026: Prompt API como porta de entrada, Transformers.js para cross-browser, cloud como último recurso
Parece complicado — e é. Mas entender como essas peças se encaixam muda a qualidade das decisões que você toma hoje e te prepara pro que vem amanhã.
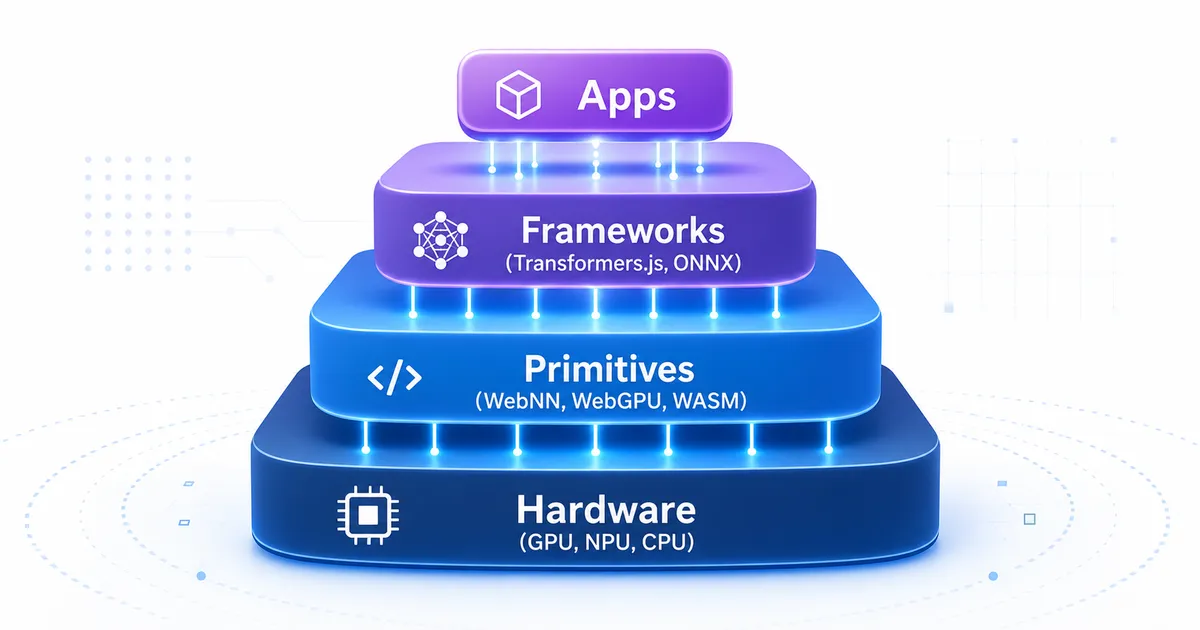
As três camadas
| Camada | O que é | Exemplos | Controle do dev |
|---|---|---|---|
| APIs built-in | Modelos gerenciados pelo browser | Prompt API, Summarizer, Translator | Nenhum (modelo fixo) |
| Frameworks JS | Bibliotecas com modelos escolhidos pelo dev | Transformers.js, ONNX Runtime Web, MediaPipe | Total |
| Primitivas de hardware | APIs de baixo nível para aceleração | WebNN, WebGPU, WebAssembly | Via frameworks |
A Prompt API vive na camada 1 — zero config, mas zero controle sobre o modelo. Quando você precisa escolher qual modelo rodar, desce para Transformers.js ou ONNX (camada 2). A camada 3 é infraestrutura que as de cima consomem.
WebNN: acesso ao hardware neural
O que é
A Web Neural Network API (WebNN) é uma spec W3C que expõe operações de redes neurais otimizadas para o hardware disponível — GPU, CPU, e especialmente NPUs (Neural Processing Units). Esses chips dedicados a IA vêm nos processadores modernos: Intel Meteor Lake, Qualcomm Snapdragon X, Apple M-series.
O lance das NPUs é eficiência energética. Uma NPU pode fazer inferência gastando 10-50x menos energia que a GPU. Para dispositivos na bateria, isso muda o jogo.
Status real em junho de 2026
| Browser | WebNN | Backend |
|---|---|---|
| Chrome (Windows) | Parcial (Developer Preview) | DirectML via NPU/GPU |
| Edge (Windows) | Parcial (Developer Preview) | DirectML via NPU/GPU |
| Chrome (macOS) | Não | — |
| Chrome (Linux) | Não | — |
| Firefox | Não | — |
| Safari | Não | — |
A spec está como W3C Candidate Recommendation desde janeiro de 2025, com 95 operações definidas. Mas a implementação real é parcial — a maioria dos devs acessa WebNN indiretamente via frameworks.
Por que importa
Sem WebNN, frameworks como ONNX Runtime Web usam WebGPU (GPU genérica) ou WASM (CPU). Com WebNN, podem acessar NPUs com eficiência muito superior e paths otimizados por fabricante (Intel OpenVINO, Qualcomm QNN, Apple Core ML).
import * as ort from 'onnxruntime-web';

// Chain de fallback: WebNN → WebGPU → WASM
const session = await ort.InferenceSession.create('./modelo.onnx', {
  executionProviders: ['webnn', 'webgpu', 'wasm']
});
WebGPU para ML
O WebGPU é a API moderna de GPU, sucessora do WebGL. Em 2026 é production-ready para ML:
| Browser | WebGPU | Status |
|---|---|---|
| Chrome 113+ | ✅ | Estável desde 2023 |
| Edge 113+ | ✅ | Estável |
| Firefox Nightly | ✅ | Em desenvolvimento |
| Safari 18+ | ✅ | Parcial |
WebGPU não é uma API de ML — é compute. Frameworks usam para rodar multiplicação de matrizes e convoluções na GPU. A performance comparada com WASM:
| Framework | WebGPU | WASM | Speedup |
|---|---|---|---|
| Transformers.js v4 | 15-40 tok/s | 3-8 tok/s | ~4-5x |
| ONNX Runtime Web | Variável | Baseline | ~3-6x |
A diferença é significativa. WebGPU transforma modelos que eram inutilizáveis via WASM em viáveis para uso real.
Transformers.js v4: o que mudou
A versão 4 do Transformers.js (2026) foi uma reescrita séria:
| Feature | v3 | v4 |
|---|---|---|
| Runtime WebGPU | JavaScript (lento) | C++ reescrito (rápido) |
| Modelos máximos | ~3B parâmetros | 8B+ parâmetros |
| Arquiteturas | ~50 | ~200 |
| Quantização | q8, q4 | q4f16, q2 (mais compactos) |
| Performance vs v3 | Baseline | 2-4x mais rápido |
Com v4, modelos maiores ficam viáveis no browser:
| Modelo | Tamanho (quantizado) | Tarefa | Viável no browser? |
|---|---|---|---|
| Gemma 3 1B | ~600MB | Text generation | ✅ Bom |
| Phi-3.5 Mini | ~2.3GB | Reasoning | ⚠️ Pesado mas possível |
| Llama 3.2 1B | ~700MB | Text generation | ✅ Bom |
| Whisper Tiny | ~150MB | Speech-to-text | ✅ Excelente |
| BGE Small | ~130MB | Embeddings | ✅ Excelente |
Prompt API vs Transformers.js
| Critério | Prompt API | Transformers.js |
|---|---|---|
| Setup | 2 linhas | Gerenciar downloads, cache |
| Modelo | Fixo (Gemini Nano) | Qualquer do HuggingFace |
| Download | ~4 GB (compartilhado cross-origin) | Varia (cada origin baixa) |
| Structured output | ✅ Nativo | ❌ Parsing manual |
| Browser support | Chrome/Edge | Qualquer com WebGPU/WASM |
| Atualização | Automática (Chrome) | Manual (dev controla) |
A Prompt API é a porta de entrada — simplicidade máxima. Transformers.js é para quando você precisa de controle total.
ONNX Runtime Web
O runtime ONNX da Microsoft roda qualquer modelo .onnx no browser:
import * as ort from 'onnxruntime-web';

const session = await ort.InferenceSession.create('./model.onnx', {
  executionProviders: [
    { name: 'webnn', deviceType: 'gpu' },
    'webgpu',
    'wasm'
  ]
});| Provider | Performance | Compatibilidade | NPU |
|---|---|---|---|
| WebNN | Melhor | Limitada | ✅ |
| WebGPU | Boa | Boa | ❌ |
| WASM (SIMD) | OK | Universal | ❌ |
Quando usar ONNX vs Transformers.js: ONNX para modelos custom treinados por você ou controle granular de inferência. Transformers.js para modelos do HuggingFace com API de alto nível.
MediaPipe: visão computacional em tempo real
O MediaPipe (Google) oferece solutions prontas para percepção:
| Solution | Função | Performance |
|---|---|---|
| Face Detection | Detecção de rostos | 30+ FPS |
| Hand Tracking | Mãos (21 pontos) | 30+ FPS |
| Pose Estimation | Corpo (33 pontos) | 25+ FPS |
| Object Detection | Objetos | 20+ FPS |
| Image Segmentation | Segmentação | 15+ FPS |
MediaPipe roda via WASM/WebGPU e complementa a Prompt API para tarefas de percepção em tempo real — algo que o Gemini Nano não faz bem (é lento demais para real-time).
Como as peças se encaixam
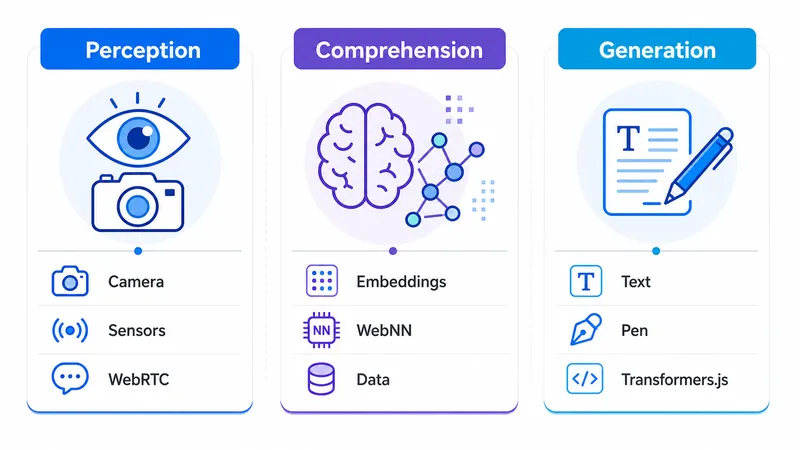
┌─────────────────────────────────────────────────────────┐
│                 IA ON-DEVICE NO BROWSER                   │
├──────────────────┬──────────────────┬───────────────────┤
│ PERCEPÇÃO        │ COMPREENSÃO      │ GERAÇÃO           │
│ (tempo real)     │ (batch)          │ (texto)           │
│                  │                  │                   │
│ MediaPipe        │ ONNX Runtime     │ Prompt API        │
│ - Faces          │ Transformers.js  │ - Chat/Q&A        │
│ - Poses          │ - Embeddings     │ - Resumo          │
│ - Objetos        │ - Classificação  │ - Classificação   │
│ - Segmentação    │ - Custom models  │ - Structured out  │
│                  │                  │                   │
│ WebGPU + WASM    │ WebGPU + WebNN   │ Gemini Nano       │
└──────────────────┴──────────────────┴───────────────────┘
A Prompt API é a porta de entrada: zero config, funciona em 2 linhas. Quando precisa de mais — modelos custom, embeddings, tempo real — desce para os frameworks.
O papel dos players
Apple
Não implementa a Prompt API, mas tem IA on-device robusta via Core ML e Apple Intelligence. Para Safari, a estratégia parece ser APIs task-specific (tradução, resumo) sem expor LLMs genéricos via JavaScript.
Microsoft
Multi-frente: DirectML (inferência Windows), Phi-4/Aion (modelos on-device no Edge), ONNX Runtime (framework open-source), WebNN (co-propositor). Em junho 2026, expandindo com Aion-1.0-Instruct que roda até sem GPU.
Modelos open-source
O que viabiliza o Transformers.js na prática:
| Modelo | Criador | Params | No browser? | Licença |
|---|---|---|---|---|
| Phi-4-mini | Microsoft | 4B | ⚠️ Pesado | MIT |
| Llama 3.2 1B | Meta | 1B | ✅ | Llama License |
| Gemma 3 1B | 1B | ✅ | Gemma License | |
| SmolLM2 | HuggingFace | 135M-1.7B | ✅ | Apache 2.0 |
| Qwen2.5 0.5B | Alibaba | 500M | ✅ | Apache 2.0 |
Previsões 2026-2027
Curto prazo (2026 H2)
| Previsão | Probabilidade | Impacto |
|---|---|---|
| WebNN em Chrome stable (Windows) | Alta | 3-5x mais rápido em NPUs |
| Firefox implementa Translator/Summarizer | Média | Convergência parcial |
| Transformers.js roda modelos 8B+ | Alta | Alternativa ao Prompt API |
| Edge lança Aion em stable | Alta | Mais competição |
| Apple expõe ML API no Safari | Baixa | Mudaria tudo |
Médio prazo (2027)
| Previsão | Probabilidade | Impacto |
|---|---|---|
| Padrão W3C para built-in AI | Média | Interoperabilidade real |
| NPUs onipresentes em laptops | Alta | WebNN se torna prático |
| Modelos on-device > 7B viáveis | Média | Qualidade próxima a cloud |
| WebGPU universal (Firefox stable) | Alta | Fim do fallback WASM |
Como se preparar hoje
A arquitetura que faz sentido agora:
async function criarMotorIA(tarefa) {
  // 1. Prompt API nativa (melhor UX, zero config)
  if ('LanguageModel' in window) {
    const status = await LanguageModel.availability();
    if (status === 'available') {
      return { tipo: 'prompt-api', session: await LanguageModel.create() };
    }
  }

  // 2. Transformers.js com WebGPU (cross-browser, modelo escolhido)
  if (navigator.gpu) {
    const { pipeline } = await import('@huggingface/transformers');
    const pipe = await pipeline(tarefa, 'modelo-otimizado', { device: 'webgpu' });
    return { tipo: 'transformers-webgpu', pipeline: pipe };
  }

  // 3. Transformers.js com WASM (universal, mais lento)
  try {
    const { pipeline } = await import('@huggingface/transformers');
    const pipe = await pipeline(tarefa, 'modelo-otimizado', { device: 'wasm' });
    return { tipo: 'transformers-wasm', pipeline: pipe };
  } catch (e) {
    // 4. Cloud API (último recurso)
    return { tipo: 'cloud', endpoint: '/api/ia' };
  }
}
Independente de qual tecnologia “vença”, o padrão de progressive enhancement funciona: feature detect, usar o melhor disponível, degradar com graça.
FAQ
WebNN substitui a Prompt API?
Não. São camadas diferentes. WebNN é primitiva de hardware, a Prompt API é interface de alto nível. Eventualmente, a Prompt API pode usar WebNN internamente, mas para o dev continua sendo session.prompt().
Devo esperar WebNN estabilizar?
Não. WebGPU e WASM já funcionam. Quando WebNN estabilizar, apps ficam mais rápidos automaticamente — frameworks adicionam como execution provider sem mudança no seu código.
Transformers.js compete com a Prompt API?
Parcialmente. Para geração de texto, permite usar modelos que você escolhe. Porém, mais setup e cada origin baixa seu próprio modelo (não compartilhado). A Prompt API é mais simples para o caso comum.
Quando Apple vai suportar IA on-device no Safari?
Imprevisível. Apple tem IA on-device via Core ML, mas filosoficamente resiste a expor LLMs via JavaScript. Aposta mais provável: APIs task-specific (tradução, resumo) sem modelo genérico.
Posso usar WebGPU para treinar modelos no browser?
Tecnicamente possível para modelos pequenos. Mas impraticável para qualquer coisa útil. WebGPU é adequado para inferência, não treinamento em escala. Fine-tuning leve (LoRA) pode ficar viável em 2027.
Conclusão
O futuro da IA on-device não é uma tecnologia vencedora. É um ecossistema em camadas, onde cada peça resolve um problema diferente:
- Prompt API: porta de entrada pra IA generativa — simples, rápido, bom o suficiente
- Transformers.js / ONNX: qualquer modelo, controle total, mais trabalho
- WebGPU: aceleração GPU que torna modelos viáveis
- WebNN: aceleração NPU pra eficiência energética (o futuro próximo)
- MediaPipe: percepção em tempo real — outro bicho
A estratégia em 2026 é progressive enhancement em múltiplas camadas. Prompt API quando disponível, Transformers.js pra cross-browser, cloud como último recurso. Sua app funciona independente do browser ou hardware do usuário — e isso, no fim, é o que importa.
Comece pela introdução à Prompt API e evolua conforme seu projeto demanda.
Voltar ao início: O que é a Prompt API | Structured Output | Multimodal